{
"cells": [
{
"cell_type": "markdown",
"id": "b8fe8bda",
"metadata": {},
"source": [
"# readDiag\n",
"\n",
"O pacote `readDiag` foi concebido para ser uma ferramenta que possibilita o fácil acesso aos arquivos diagnósticos gerados pelo [Gridpoint Statistical Interpolation (GSI) system](https://github.com/NOAA-EMC/GSI). O pacote é composto principalmente por 2 classes, a primeira para ler os dados (`read_diag`) e outra para fazer diferentes tipos de figuras com dados selecionados (`plot_diag`).\n",
"\n",
"## A Classe `read_diag`\n",
"\n",
"A classe read_diag é composta por 5 funções:\n",
"\n",
"1. `__init__(self, diagFile, diagFileAnl=None, isisList=None, zlevs=None)`: sendo `diagFile` o arquivo de diagnóstico do primeiro outer loop com informação do OmF e `diagFileAnl` do último outer loop com informação do OmA. Note que não é necessário informar os dois arquivos, o `diagFileAnl` é opcional. Neste caso, a informação lida (Omf ou OmA) dependerá do outer loop (arquivo diagnóstico) fornecido;\n",
"2. `overview(self)`: esta função cria e retorna um dicionário com as informações existentes no arquivo;\n",
"3. `pfileinfo(self)`: esta função imprime de forma elegante uma lista com as informações existentes no arquivo;\n",
"4. `close(self)`: esta função fecha o último arquivo aberto;\n",
"5. `tocsv(self, varName=None, varType=None, dateIni=None, dateFin=None, nHour=\"06\", Level=None, Lay=None, SingleL=None)`: esta função gera um arquivo CSV dos parâmetros OmF e OmA com as seguintes informações: data, média, desvio-padrão e total de dados para a variável e tipo escolhidos.\n",
" \n",
"Os dados de entrada da função e funcionalidades são idênticas àquelas da função `time_series` que é apresentada na próxima seção na classe `plot_diag` (item 7 - ver também detalhes das funcionalidades [aqui](#time_series)). O que distingue as duas funções é que esta escreve um arquivo CSV e a outra gera figuras de séries temporais.\n",
"\n",
"## A Classe `plot_diag`\n",
" \n",
"A classe plot_diag é composta por 7 funções:\n",
"\n",
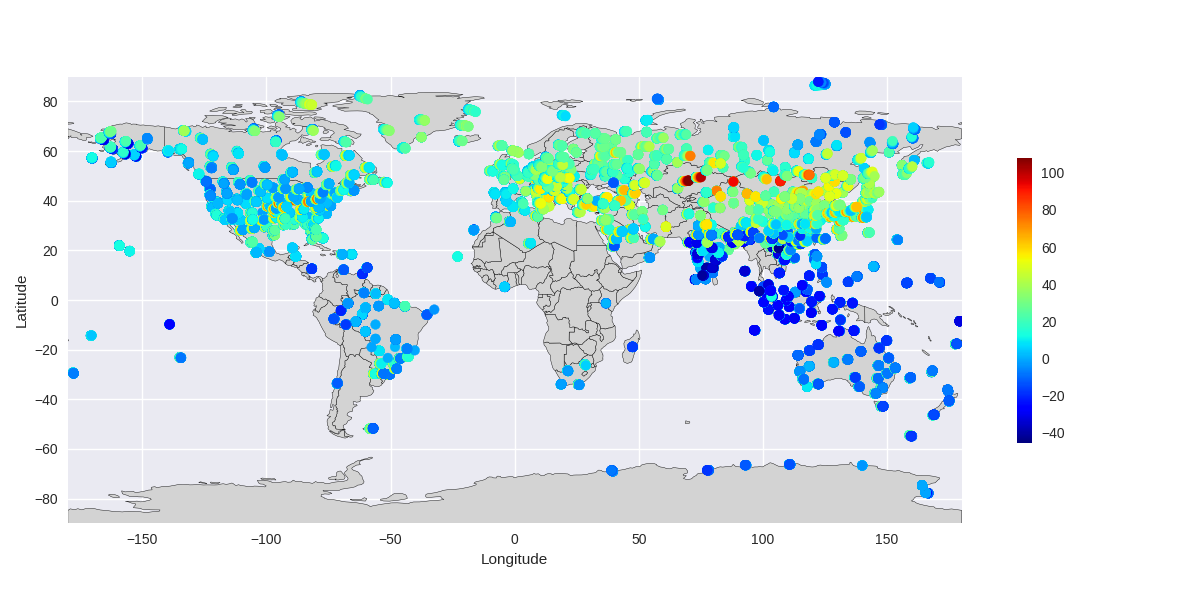
"1. `plot(self, varName, varType, param, mask=None, **kwargs)`: a função `plot` gera uma figura para a variável `varName` (ex: `uv`), `varType` (ex: `220` (dropssonda)) e `param`, que pode ser várias opções como: `param=\"obs\"` para o valor da observação, `param=\"omf\"` para observação menos background ou `param=\"oma\"` para observação menos análise. Também é possível mascarar os dados com a variável `iuse`, que indica se o dado foi (`iuse=1`) ou não (`iuse=-1` - dado monitorado) utilizado na assimilação. Abaixo há um exemplo executado para `varName=\"uv\"`, `varType=220`, `param=\"obs\"` e mask `iuse==1\"`;\n",
"\n",
" \n",
"
\n",
" \n",
"2. `ptmap(self, varName, varType=None, mask=None, **kwargs)`: a função `ptmap` gera uma figura com a localização de todas as observações definidas por `varName` (ex: `uv`) e `varType` (pode ser um único tipo ou uma lista, ex: `[200]` ou `[220,221,257]`. Se `varType` não for informado, então todos os tipos serão incluídos na figura. Também é possível mascarar os dados com a variável `iuse`, que indica se o dado foi (`iuse=1`) ou não (`iuse=-1` - dado monitorado) utilizado na assimilação. Abaixo há um exemplo executado para `varName=\"uv\"`, `varType=[254,242,221,220,257,258,281,280]` e `mask=None`; \n",
"\n",
" \n",
"
\n",
"\n",
"3. `pvmap(self, varName=None, mask=None, **kwargs)`: a função `pvmap` é similar à função `ptmap`, com a diferença de não especificar o tipo (`varType`), podendo então escolher uma lista de variáveis, ex: `[\"uv\",\"ps\",\"t\"]`. Abaixo há um exemplo executado para `varName=['uv','ps','t']`, e `mask=None`; \n",
"\n",
" \n",
"
\n",
"\n",
"4. `pcount(self,varName,**kwargs)`: a função `pcount` gera um histograma da quantidade de dados para uma determinada variável `varName` (ex: `uv`) e todos os tipos disponíveis (`varType`);\n",
"\n",
" \n",
"
\n",
"\n",
"5. `kxcount(self,**kwargs)`: a função `kxcount` é similar à `pcount`, porém não especifica a variável (`varName`). Esta função gera um histograma com o total de dados (todas as variáveis somadas) para todos os tipos disponíveis (`varType`);\n",
"\n",
" \n",
"
\n",
"\n",
"6. `vcount(self,**kwargs)`: a função `vcount` gera um histograma com a quantidade total de dados para cada variável (`ps`, `t`, `q`, `uv`);\n",
"\n",
" \n",
"
\n",
"\n",
"7. `time_series(self, varName=None, varType=None, dateIni=None, dateFin=None, nHour=\"06\", vminOMA=None, vmaxOMA=None, vminSTD=0.0, vmaxSTD=14.0, Level=None, Lay=None, SingleL=None, Clean=None)`: a função `time_series` pode gerar 6 tipos distintos de figuras, dependendo da configuração especificada na sua chamada. A característica comum entre os 6 tipos é a variação no tempo, enquanto que a diferença entre os 6 tipos é a forma de tratar os níveis verticais. Basicamente estas formas são distribuídas entre variar na vertical (diferentes valores para diferentes níveis/camadas) e fixo na vertical (nível específico, média na camada ou toda a atmosfera). \n",
"\n",
"A seguir são apresentados os parâmetros de entrada na função e cada uma das opções de figuras será explicada em mais detalhes.\n",
" \n",
"| Parâmetro | Exemplo | Descrição\n",
"| :--- | :---: | :---\n",
"| `self` | `['/home/user/diag_conv_01.2019121000']` | Lista com todos os caminhos completos (`caminho/nome_do_arquivo`) de cada tempo da série temporal. \n",
"| `varName` | `uv` | Nome da variável \n",
"| `varType` | `220` | Tipo da variável\n",
"| `dateIni` | `2019121000` | Data inicial da série temporal\n",
"| `dateFin` | `2019121118` | Data final da série temporal\n",
"| `nHour` | `6` | Intervalo de tempo em horas entre cada arquivo na lista `self`\n",
"| `vminOMA` | `-2.0` | Valor mínimo da escala y (ordenada) para OmF e OmA\n",
"| `vmaxOMA` | `2.0` | Valor máximo da escala y (ordenada) para OmF e OmA\n",
"| `vminSTD` | `0.0` | Valor mínimo da escala y (ordenada) para o desvio-padrão\n",
"| `vmaxSTD` | `14.0` | Valor máximo da escala y (ordenada) para o desvio-padrão\n",
"| `Level` | `Zlevs` | Valor do nível a ser feita a série temporal, opções: valor numérico referente ao nível, ex.: 1000 p/ 1000 hPa; `Zlevs` para plotar por camadas (em torno dos níveis padrão); `None` para plotar de todos os níveis.\n",
"| `Lay` | 25 | Metade do tamanho da camada (se `Level=\"Zlevs\"`) em hPa se optar por amostragem em camadas. Se `Lay=None`, `Lay` será calculada internamente para preencher toda a atmosfera contendo os níveis padrão.\n",
"| `SingleL` | `All` | Quando `Level` for fixo, ex: 1000 hPa, será considerado exatamente esse nível (usando a opção `SingleL=None`) ou em todos os níveis como uma única camada (usando `SingleL=\"All\"`) ou em uma camada definida em torno do valor de `Level` variando entre `Level-Lay` e `Level+Lay`. Se `Lay` não for informado, será usado um valor padrão de 50 hPa.\n",
"| `Clean` | `True` ou `False` | Se `True`, após gerar e salvar a figura, a janela da figura é reiniciada (`plt.clf()`) ou fechada (`plt.close()`), se `False`, este procedimento é eliminado e a figura continua disponível para visualização com `plt.show()`.\n",
"\n",
"Todas as figuras geradas com a opção `Level` igual a `None` ou `Zlevs` conterá no nome o termo `all_levels`, caso contrário será `level` ou `layer`, dependendo da opção `SingleL`.\n",
"\n",
"No decorrer deste notebook são mostrados exemplos com recortes de código para exemplificar o uso das funções acima elencadas.\n",
"\n",
"## Utilização da classe `read_diag`\n",
"\n",
"### Bibliotecas necessárias\n",
"\n",
"Para iniciar a utilização do `readDiag`, carregue primeiro as bibliotecas necessárias para a sua utilização:\n",
"\n",
"* `gsidiag`: é a biblioteca que contém as classes `read_diag` e `plot_diag`;\n",
"* `pandas`: é a biblioteca que fornece as estruturas de dados tabulados utilizadas pelo `readDiag`;\n",
"* `matplotlib`: é a biblioteca a partir da qual são confeccionadas as figuras;\n",
"* `datetime`: é a biblioteca utilizada para manipular datas.\n",
"\n",
"A instrução `%matplotlib inline` é um comando mágico do Jupyter e apenas ajusta o ambiente para que não seja necessário utilizar o comando `plt.show()` sempre que figuras forem mostradas dentro do notebook. Se você estiver utilizando o `readDiag` dentro de um script Python, esta diretiva pode ser suprimida e o comando `plt.show()` deve ser utilizado, a depender da situação."
]
},
{
"cell_type": "code",
"execution_count": null,
"id": "36e5dd3a-77f6-47d2-b503-2a0184a245a4",
"metadata": {},
"outputs": [],
"source": [
"# Descomente a linha a seguir para utilizar este notebook no Google Colab\n",
"#!pip install readDiag"
]
},
{
"cell_type": "code",
"execution_count": null,
"id": "7bd343fb",
"metadata": {
"tags": []
},
"outputs": [],
"source": [
"import gsidiag as gd\n",
"\n",
"import pandas as pd\n",
"import matplotlib.pyplot as plt\n",
"from datetime import datetime, timedelta\n",
"\n",
"%matplotlib inline"
]
},
{
"cell_type": "markdown",
"id": "62634f50",
"metadata": {},
"source": [
"### Variáveis principais\n",
"\n",
"Na tabela a seguir, estão relacionadas os valores padrão das variáveis utilizadas ao longo deste tutorial. Observe que as variáveis possuem diferentes tipos e que algumas podem ser declaradas como `None`.\n",
"\n",
"| Variáveis | | Valores | Tipo |\n",
"| :---: |:---:| :--- | :--- |\n",
"| `DIRdiag` | = | `/pesq/share/das/dist/joao.gerd/EXP18/GSI/dataout` | string |\n",
"|`varName` | = | `uv` | string | \n",
"|`varType` | = | `220` | integer | \n",
"|`dateIni` | = | `2019121000` | string |\n",
"|`dateFin` | = | `2019121118` | string |\n",
"|`nHour` | = | `6` | string | \n",
"|`vminOMA` | = | `-2.0` | float |\n",
"|`vmaxOMA` | = | `2.0` | float |\n",
"|`vminSTD` | = | `0.0` | float |\n",
"|`vmaxSTD` | = | `14.0` | float |\n",
"|`Level` | = | `1000` | integer ou `None` |\n",
"|`Lay` | = | `15` | integer ou `None` |\n",
"|`SingleL` | = | `OneL` | string |\n",
" \n",
"Dessa forma, na célula a seguir são ajustadas as variáveis seguindo os valores da tabela acima. Além disso, são ajustados também os valores das datas para compor o caminho e os nomes dos arquivos de diagnóstico do GSI:"
]
},
{
"cell_type": "code",
"execution_count": null,
"id": "c524c794",
"metadata": {
"tags": []
},
"outputs": [],
"source": [
"# Para uso na Egeon\n",
"#DIRdiag = \"/pesq/share/das/dist/joao.gerd/EXP18/GSI/dataout\"\n",
"\n",
"# Para uso na Itapemirim (Colorado, Ilopolis e outras máquinas virtuais)\n",
"#DIRdiag = \"/share/das/dist/joao.gerd/EXP18/GSI/dataout\"\n",
"\n",
"# Para uso em máquina local (neste caso, o diretório remoto deverá ser montado localmente com o comando sshfs)\n",
"# Exemplo: \n",
"# $ sshfs username@egeon.cptec.inpe.br:/pesq/share/das/dist/joao.gerd/EXP18/GSI/dataout /extra2/EGEON_EXP18_GSI_dataout\n",
"# ou\n",
"# $ sshfs username@itapemirim.cptec.inpe.br:/share/das/dist/joao.gerd/EXP18/GSI/dataout /extra2/EGEON_EXP18_GSI_dataout\n",
"DIRdiag = '/extra2/EGEON_EXP18_GSI_dataout'\n",
"\n",
"varName = 'uv'\n",
"varType = 220\n",
"dateIni = '2019121000' \n",
"dateFin = '2019121118' \n",
"nHour = '6' \n",
"vminOMA = -2.0 \n",
"vmaxOMA = 2.0 \n",
"vminSTD = 0.0 \n",
"vmaxSTD = 14.0 \n",
"Level = 1000\n",
"Lay = 15 \n",
"SingleL = 'OneL' \n",
"\n",
"datei = datetime.strptime(str(dateIni), '%Y%m%d%H')\n",
"datef = datetime.strptime(str(dateFin), '%Y%m%d%H')\n",
"dates = [dates.strftime('%Y%m%d%H') for dates in pd.date_range(datei, datef,freq='6H').tolist()]\n",
"\n",
"print(dates)"
]
},
{
"cell_type": "markdown",
"id": "8d3337a9",
"metadata": {},
"source": [
"Gerando as variáveis `path` e `pathc` onde estarão os caminhos completos (incluindo nome do arquivo) dos arquivos diagnósticos do primeiro (OmF) e último (OmA) outer loop:"
]
},
{
"cell_type": "code",
"execution_count": null,
"id": "5322fbbf",
"metadata": {
"tags": []
},
"outputs": [],
"source": [
"paths, pathsc = [], []\n",
"\n",
"OuterL = '01' \n",
"[paths.append(DIRdiag + '/' + dt + '/diag_conv_' + OuterL + '.' + dt) for dt in dates]\n",
"\n",
"OuterLc = '03'\n",
"[pathsc.append(DIRdiag + '/' + dt + '/diag_conv_' + OuterLc + '.' + dt) for dt in dates]\n",
"\n",
"print(paths)\n",
"print('')\n",
"print(pathsc)"
]
},
{
"cell_type": "markdown",
"id": "cb3223cc",
"metadata": {},
"source": [
"### Leitura dos arquivos de diagnósticos\n",
"\n",
"**Nota:** a leitura dos arquivos de diagnóstico seguindo os valores ajustados para os parâmetros acima, requer pelo menos 8GB de memória RAM. Caso seja necessário, ajuste os parâmetros para considerar um intervalo menor.\n",
"\n",
"Lendo os arquivos diagnósticos com a função `read_diag()` do pacote `readDiag`. No trecho de código a seguir, observe que a função `read_diag()` é utilizada dentro de um loop que varia sobre todos os arquivos das listas `paths` e `pathsc` definidas no passo anterior. No final do loop, é gerada a lista `gdf_list` que conterá todos os arquivos lidos pelo `readDiag`:"
]
},
{
"cell_type": "code",
"execution_count": null,
"id": "5d8035ca",
"metadata": {
"tags": []
},
"outputs": [],
"source": [
"read = True\n",
"\n",
"if read: \n",
" gdf_list = []\n",
" print('')\n",
" \n",
" print('Aguarde, o tempo total estimado para a leitura dos arquivos é de ' +\n",
" str(int((float(len(paths))*20)/60)) + ' minutos e ' +\n",
" str(int((float(len(paths))*20)%60)) + ' segundos.')\n",
" \n",
" print('')\n",
" \n",
" for path, pathc in zip(paths, pathsc):\n",
" print('Reading ' + path)\n",
" \n",
" gdf = gd.read_diag(path, pathc)\n",
" \n",
" gdf_list.append(gdf)\n",
" \n",
" print('Pronto!') "
]
},
{
"cell_type": "markdown",
"id": "2a1a2bfd",
"metadata": {},
"source": [
"A variável `gdf_list` é uma lista de dataframes contendo os dados de cada arquivo diagnóstico. Para trabalhar com um único tempo basta informar a lista com o índice fixo, por exemplo: `gdf_list[0]`:"
]
},
{
"cell_type": "code",
"execution_count": null,
"id": "655590bb",
"metadata": {
"tags": []
},
"outputs": [],
"source": [
"gdf_list"
]
},
{
"cell_type": "markdown",
"id": "28e3569a-1b5d-451d-9e15-720a9153e6b7",
"metadata": {},
"source": [
"Fazendo `tidx = 0`, obtemos o primeiro objeto da lista `gdf_list`:"
]
},
{
"cell_type": "code",
"execution_count": null,
"id": "88d8af81",
"metadata": {
"tags": []
},
"outputs": [],
"source": [
"tidx = 0\n",
"gdf_list[tidx]"
]
},
{
"cell_type": "markdown",
"id": "f4ad8170-bffd-4c93-a51a-5747b88478b1",
"metadata": {
"tags": []
},
"source": [
"### Obtendo informações dos arquivos\n",
"\n",
"Utilize a função `pfileinfo()` para obter uma lista das observações e seus respectivos tipos (`kx`) que estão contidos dentro do arquivo:"
]
},
{
"cell_type": "code",
"execution_count": null,
"id": "83af7ed8",
"metadata": {
"tags": []
},
"outputs": [],
"source": [
"gdf_list[tidx].pfileinfo()"
]
},
{
"cell_type": "markdown",
"id": "7e1f38c4-1212-410f-9148-1982a7bbf5cb",
"metadata": {},
"source": [
"Além do método `pfileinfo()`, outros métodos e funções também podem ser utilizados para acessar as informações sobre os arquivos abertos. Para obter uma lista dos métodos e funções disponíveis, digite `gdf_list[tidx].` e pressione a tecla `` duas vezes no teclado:\n",
"\n",
"```python\n",
">>> gdf_list[tidx].\n",
"gdf_list[tidx].close( gdf_list[tidx].obsInfo gdf_list[tidx].pfileinfo( gdf_list[tidx].zlevs \n",
"gdf_list[tidx].tocsv( gdf_list[tidx].overview( gdf_list[tidx].varNames \n",
"gdf_list[tidx].obs\n",
"```\n",
"\n",
"Os métodos e funções embutidas possuem documentação, as quais podem ser acessadas da seguinte forma:\n",
"\n",
"```python\n",
"print(object.function_name.__doc__)\n",
"```\n",
"\n",
"ou\n",
"\n",
"```python\n",
"help(object.function_name)\n",
"```\n",
"\n",
"Por exemplo:"
]
},
{
"cell_type": "code",
"execution_count": null,
"id": "ec440584-05c6-4ca5-a150-f32b3df367f8",
"metadata": {
"tags": []
},
"outputs": [],
"source": [
"print(gdf_list[tidx].pfileinfo.__doc__)"
]
},
{
"cell_type": "markdown",
"id": "8fb93454-49f9-4f25-899e-d89344d8c5a8",
"metadata": {},
"source": [
"ou ainda:"
]
},
{
"cell_type": "code",
"execution_count": null,
"id": "9be857b1-4371-4528-ac22-477878108426",
"metadata": {
"tags": []
},
"outputs": [],
"source": [
"help(gdf_list[tidx].pfileinfo)"
]
},
{
"cell_type": "markdown",
"id": "17224ffc-c96d-42a9-beda-7e7a6d72c8f1",
"metadata": {},
"source": [
"Para obter um dicionário com todas as informações sobre as variáveis e tipos contidos no arquivo, utilize o método `obsInfo`:"
]
},
{
"cell_type": "code",
"execution_count": null,
"id": "c8c368b1",
"metadata": {
"tags": []
},
"outputs": [],
"source": [
"gdf_list[tidx].obsInfo"
]
},
{
"cell_type": "markdown",
"id": "2da780bf",
"metadata": {},
"source": [
"Para acessar uma variável específica (ex: `uv`), faça:"
]
},
{
"cell_type": "code",
"execution_count": null,
"id": "75438415",
"metadata": {
"tags": []
},
"outputs": [],
"source": [
"print('Variável: ', varName)\n",
"\n",
"gdf_list[tidx].obsInfo[varName]"
]
},
{
"cell_type": "markdown",
"id": "769f7e52",
"metadata": {},
"source": [
"Para acessar variável e tipo específicos (ex: `uv` do tipo `220`), faça:"
]
},
{
"cell_type": "code",
"execution_count": null,
"id": "8265a96d",
"metadata": {
"tags": []
},
"outputs": [],
"source": [
"print('Variável: ', varName, ' e Tipo: ', varType)\n",
"\n",
"gdf_list[tidx].obsInfo[varName].loc[varType]"
]
},
{
"cell_type": "markdown",
"id": "da23137b",
"metadata": {},
"source": [
"O parâmetro `varType` pode ser também uma lista, ex: `varType=[220,221]`:"
]
},
{
"cell_type": "code",
"execution_count": null,
"id": "fc0be327",
"metadata": {
"tags": []
},
"outputs": [],
"source": [
"varTypes = [220,221]\n",
"\n",
"print('Variável: ', varName, ' e Tipos: ', varTypes)\n",
"\n",
"gdf_list[tidx].obsInfo[varName].loc[varTypes]"
]
},
{
"cell_type": "markdown",
"id": "936ea5b0",
"metadata": {},
"source": [
"Para acessar o valor da observação, utilize o método `obs`:"
]
},
{
"cell_type": "code",
"execution_count": null,
"id": "8d7f6cea",
"metadata": {
"tags": []
},
"outputs": [],
"source": [
"print('Variável: ', varName, ' e Tipo: ', varType)\n",
"\n",
"gdf_list[tidx].obsInfo[varName].loc[varType].obs"
]
},
{
"cell_type": "markdown",
"id": "baaf3d6a",
"metadata": {},
"source": [
"## Utilização da classe `plot_diag`\n",
"\n",
"### Distribuição espacial\n",
"\n",
"A utilização das funções da classe `plot_diag` é apresentada abaixo, junto com os comandos para gerar diversos tipos de figuras.\n",
"\n",
"Gerando uma figura com os valores das observações (`param='obs'`) para a variável e tipo selecionados:"
]
},
{
"cell_type": "code",
"execution_count": null,
"id": "6c16f7d1",
"metadata": {
"tags": []
},
"outputs": [],
"source": [
"param = 'obs'\n",
"\n",
"gd.plot_diag.plot(gdf_list[tidx], \n",
" varName=varName, \n",
" varType=varType, \n",
" param=param, \n",
" mask='iuse == 1', \n",
" legend='true')"
]
},
{
"cell_type": "markdown",
"id": "f82df541",
"metadata": {},
"source": [
"Para salvar a figura, defina o seu nome (`figname`) e execute os comandos a seguir:"
]
},
{
"cell_type": "code",
"execution_count": null,
"id": "84169c19",
"metadata": {
"tags": []
},
"outputs": [],
"source": [
"figname = varName + '_' + param + '_' + 'plot.png'\n",
"\n",
"plt.tight_layout()\n",
"plt.savefig(figname)"
]
},
{
"cell_type": "markdown",
"id": "2a240e9d-3d2a-48e3-a76a-f09fc6331a1d",
"metadata": {},
"source": [
"Gerando a mesma figura, mas considerando vários tipos diferentes (`kx`) da observação selecionada:"
]
},
{
"cell_type": "code",
"execution_count": null,
"id": "0be7a398",
"metadata": {
"tags": []
},
"outputs": [],
"source": [
"varTypes = [254,242,221,220,257,258,281,280]\n",
"idschar = '_'.join([str(item) for item in varTypes])\n",
"\n",
"gd.plot_diag.ptmap(gdf_list[tidx], varName=varName, varType=varTypes)\n",
"\n",
"figname = varName + '_' + idschar + '_' + 'ptmap.png'\n",
"\n",
"plt.tight_layout()\n",
"plt.savefig(figname)"
]
},
{
"cell_type": "markdown",
"id": "fb0eaa77-fca0-4be6-8d82-1ef7794bab0b",
"metadata": {},
"source": [
"Gerando uma figura com diferentes variáveis, considerando a máscara `iuse==1`:"
]
},
{
"cell_type": "code",
"execution_count": null,
"id": "8bdc6d6a",
"metadata": {
"tags": []
},
"outputs": [],
"source": [
"varNames = ['uv','ps','t']\n",
"idschar = '_'.join([str(item) for item in varNames])\n",
"\n",
"gd.plot_diag.pvmap(gdf_list[tidx], varName=varNames, mask='iuse==1')\n",
"\n",
"figname = idschar + '_pvmap.png'\n",
"\n",
"plt.tight_layout()\n",
"plt.savefig(figname)"
]
},
{
"cell_type": "markdown",
"id": "a48cf904-ad49-4d2e-9415-6bec88ab48cc",
"metadata": {},
"source": [
"### Histograma\n",
"\n",
"Utilize a função `pcount()` da classe `plot_diag` para obter um histograma com a contagem do número de observações para uma determinada variável:"
]
},
{
"cell_type": "code",
"execution_count": null,
"id": "078f84a8",
"metadata": {
"tags": []
},
"outputs": [],
"source": [
"gd.plot_diag.pcount(gdf_list[tidx], varName)"
]
},
{
"cell_type": "markdown",
"id": "368a57ec-9e04-4394-a9d7-4cb4bba1b0a3",
"metadata": {},
"source": [
"Utilize a função `vcount()` da classe `plot_diag` para obter um histograma com a contagem do número de observações para todos os tipos de variáveis:"
]
},
{
"cell_type": "code",
"execution_count": null,
"id": "b1d44398",
"metadata": {
"tags": []
},
"outputs": [],
"source": [
"gd.plot_diag.vcount(gdf_list[tidx])"
]
},
{
"cell_type": "markdown",
"id": "f50747e4-44c9-48d3-a150-ec640573cb18",
"metadata": {},
"source": [
"De forma semelhante, utilize a função `kxcount()` da classe `plot_diag` para obter um histograma com a contagem do número de observações por tipo:"
]
},
{
"cell_type": "code",
"execution_count": null,
"id": "46deda00",
"metadata": {
"tags": []
},
"outputs": [],
"source": [
"gd.plot_diag.kxcount(gdf_list[tidx])"
]
},
{
"cell_type": "markdown",
"id": "deb35f54",
"metadata": {},
"source": [
"### Série temporal\n",
"\n",
"\n",
"A seguir são apresentadas as opções de figuras com a função `time_series()`, incluída na classe `plot_diag`. Inicialmente é gerada uma figura com os parâmetros já fixados nesta seção. Em seguida são apresentadas figuras alterando os parâmetros `Level`, `Lay` e `SingleL`.\n",
"\n",
"Plotando uma série temporal do OmA e OmF:"
]
},
{
"cell_type": "code",
"execution_count": null,
"id": "241bc9fc",
"metadata": {
"tags": []
},
"outputs": [],
"source": [
"gd.plot_diag.time_series(gdf_list,\n",
" varName=varName, \n",
" varType=varType, \n",
" dateIni=dateIni, \n",
" dateFin=dateFin, \n",
" nHour=nHour, \n",
" vminOMA=vminOMA, \n",
" vmaxOMA=vmaxOMA, \n",
" vminSTD=vminSTD, \n",
" vmaxSTD=vmaxSTD, \n",
" Level=Level, \n",
" Lay=Lay, \n",
" SingleL=SingleL,\n",
" Clean=False)"
]
},
{
"cell_type": "markdown",
"id": "905097b2",
"metadata": {},
"source": [
"No caso anterior, o parâmetro `Level` estava fixo em 1000 hPa com `SingleL` igual a `All`, ou seja, toda a atmosfera foi considerada como uma única camada e o valor 1000 hPa funciona apenas como uma flag para indicar que não existe variação em altura. Ainda com `Level=1000`, pode-se usar `SingleL='OneL'` para uma única camada em torno do valor de `Level`, neste caso 1000 hPa, variando entre `Level-Lay` e `Level+Lay` (na definição de variáveis, `Lay` foi fixado com 15 hPa; no caso de ser `None`, o valor padrão de 50 hPa é utilizado)."
]
},
{
"cell_type": "code",
"execution_count": null,
"id": "565623bd",
"metadata": {
"tags": []
},
"outputs": [],
"source": [
"SingleL = 'OneL'\n",
"Lay = 15\n",
"\n",
"gd.plot_diag.time_series(gdf_list,\n",
" varName=varName, \n",
" varType=varType, \n",
" dateIni=dateIni, \n",
" dateFin=dateFin, \n",
" nHour=nHour, \n",
" vminOMA=vminOMA, \n",
" vmaxOMA=vmaxOMA, \n",
" vminSTD=vminSTD, \n",
" vmaxSTD=vmaxSTD, \n",
" Level=Level, \n",
" Lay=Lay, \n",
" SingleL=SingleL,\n",
" Clean=False)"
]
},
{
"cell_type": "markdown",
"id": "8771f5b9",
"metadata": {},
"source": [
"Observe como no exemplo acima a quantidade de dados diminui, uma vez que agora está sendo utilizada uma camada entre 1015 e 985 hPa.\n",
"\n",
"Agora vamos alterar para não fixar em um único nível ou camada, ou seja, altear a variável `Level` para `None` ou `Zlevs`. A opção `None` busca os dados em cada nível existente nos arquivos e faz a figura para todos esses níveis, porém os valores no eixo y (ordenada) são apenas dos níveis padrão. É importante esclarecer que os chamados níveis padrão estão definidos na classe `read_diag` e podem ser acessados utilizando o método `zlevs` da seguinte forma:"
]
},
{
"cell_type": "code",
"execution_count": null,
"id": "269a1812",
"metadata": {
"tags": []
},
"outputs": [],
"source": [
"gdf_list[tidx].zlevs"
]
},
{
"cell_type": "markdown",
"id": "29f63a5f-8d2c-4e8d-a292-89a484740c06",
"metadata": {},
"source": [
"Dessa forma, pode-se utilizar o parâmetro `Level='Zlevs'` para produzir uma série temporal por níveis:"
]
},
{
"cell_type": "code",
"execution_count": null,
"id": "7b8695b3",
"metadata": {
"tags": []
},
"outputs": [],
"source": [
"Level = 'Zlevs'\n",
"Lay = 15\n",
"\n",
"gd.plot_diag.time_series(gdf_list,\n",
" varName=varName, \n",
" varType=varType, \n",
" dateIni=dateIni, \n",
" dateFin=dateFin, \n",
" nHour=nHour, \n",
" vminOMA=vminOMA, \n",
" vmaxOMA=vmaxOMA, \n",
" vminSTD=vminSTD, \n",
" vmaxSTD=vmaxSTD, \n",
" Level=Level, \n",
" Lay=Lay, \n",
" SingleL=SingleL,\n",
" Clean=False)"
]
},
{
"cell_type": "markdown",
"id": "168e33f3",
"metadata": {},
"source": [
"Se `Lay=None`, então as camadas são preenchidas variando entre o valor médio considerando as camadas inferiores e superiores. Por exemplo, para o nível de 700 hPa é construída uma camada entre 750 e 650 hPa, uma vez que os níveis inferiores e superiores são 800 e 600 hPa, respectivamente. Para o nível de 1000 hPa a camada varia entre 1050 e 950 hPa.\n",
"\n",
"O mesmo exemplo anterior, mas considerando `Level='Zlevs'`:"
]
},
{
"cell_type": "code",
"execution_count": null,
"id": "369095b9",
"metadata": {
"tags": []
},
"outputs": [],
"source": [
"Level = 'Zlevs'\n",
"Lay = None\n",
"\n",
"gd.plot_diag.time_series(gdf_list,\n",
" varName=varName, \n",
" varType=varType, \n",
" dateIni=dateIni, \n",
" dateFin=dateFin, \n",
" nHour=nHour, \n",
" vminOMA=vminOMA, \n",
" vmaxOMA=vmaxOMA, \n",
" vminSTD=vminSTD, \n",
" vmaxSTD=vmaxSTD, \n",
" Level=Level, \n",
" Lay=Lay, \n",
" SingleL=SingleL,\n",
" Clean=False)"
]
},
{
"cell_type": "markdown",
"id": "f65d75eb",
"metadata": {},
"source": [
"Finalmente, existe a opção de se considerar todos os níveis, ou seja, `Level=None`. Esta opção traz certa dificuldade na visualização da informação na figura por conta da grande quantidade de níveis e distribuição dos dados em todos os níveis:"
]
},
{
"cell_type": "code",
"execution_count": null,
"id": "c4a84f15",
"metadata": {
"tags": []
},
"outputs": [],
"source": [
"Level = None\n",
"\n",
"gd.plot_diag.time_series(gdf_list,\n",
" varName=varName, \n",
" varType=varType, \n",
" dateIni=dateIni, \n",
" dateFin=dateFin, \n",
" nHour=nHour, \n",
" vminOMA=vminOMA, \n",
" vmaxOMA=vmaxOMA, \n",
" vminSTD=vminSTD, \n",
" vmaxSTD=vmaxSTD, \n",
" Level=Level, \n",
" Lay=Lay, \n",
" SingleL=SingleL,\n",
" Clean=False)"
]
},
{
"cell_type": "markdown",
"id": "64ddd69e-cecb-458b-b25f-27820feaa636",
"metadata": {},
"source": [
"Finalizado o uso dos arquivos, feche-os para liberar a memória utilizada:"
]
},
{
"cell_type": "code",
"execution_count": null,
"id": "9e95c31d-1cff-4047-a53e-5d5b11534aa2",
"metadata": {
"tags": []
},
"outputs": [],
"source": [
"for file in gdf_list:\n",
" file.close()"
]
},
{
"cell_type": "markdown",
"id": "ab17d898",
"metadata": {},
"source": [
"O `readDiag` é um pacote em desenvolvimento e em constante atualização. Novas funcionalidades serão adicionadas e demonstradas por meio deste notebook."
]
},
{
"cell_type": "code",
"execution_count": null,
"id": "eefbad7e-cccf-4a99-be5f-aa4d5c2dd642",
"metadata": {},
"outputs": [],
"source": []
}
],
"metadata": {
"kernelspec": {
"display_name": "Python 3 (ipykernel)",
"language": "python",
"name": "python3"
},
"language_info": {
"codemirror_mode": {
"name": "ipython",
"version": 3
},
"file_extension": ".py",
"mimetype": "text/x-python",
"name": "python",
"nbconvert_exporter": "python",
"pygments_lexer": "ipython3",
"version": "3.9.12"
}
},
"nbformat": 4,
"nbformat_minor": 5
}